数据平台 · 模型训练
6 模型功能模块
具身数据平台提供完整的机器人学习模型训练功能,支持从数据预处理到模型部署的端到端工作流。平台集成了多种主流的机器人学习算法,为研究人员和开发者提供高效的模型训练环境。
6.1 产品特色
灵活架构
产品采用分层架构设计,确保系统的可扩展性。训练的算力支持多重选择:
从数据到模型
平台已覆盖了从数据采集,标注,导出,训练微调,模型部署的数据全链路。
6.2 支持的模型类型
平台支持机器人领域的主流学习模型(以下模型,目前只上线了ACT、Pi0、Pi0.5),涵盖多种技术路线:
6.3 训练工作流程
平台提供了产品化的训练流程,无需代码能力,全程通过网页实现从数据准备到模型部署的完整操作链路。你只需要选择数据、选择模型、配置参数,然后点击开始训练。
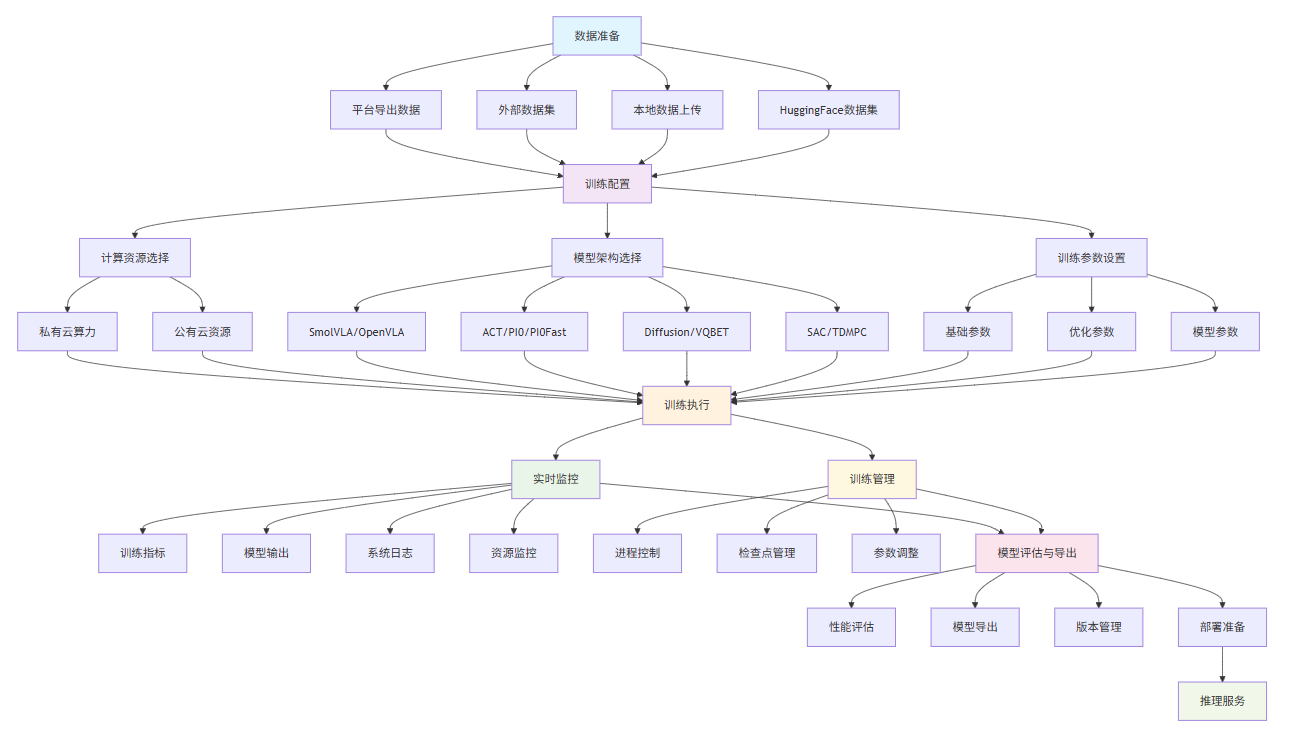
6.3.1 准备训练数据
训练数据可以来自多个来源:
- 平台导出数据(推荐):使用平台标注和导出的机器人演示数据
1.在
数据导出页面,选择已标注的数据集 2.选择 LeRobot 或 HDF5 格式导出 3.导出完成后,在训练页面选择"平台导出数据" 4.从导出历史中选择对应的导出记录 - 外部数据集:通过 URL 链接导入公开数据集
- 本地数据上传:支持 HDF5、LeRobot 等标准格式
- HuggingFace 数据集:直接从 HuggingFace Hub 获取公开数据
6.3.2 选择模型和训练资源
计算资源选择
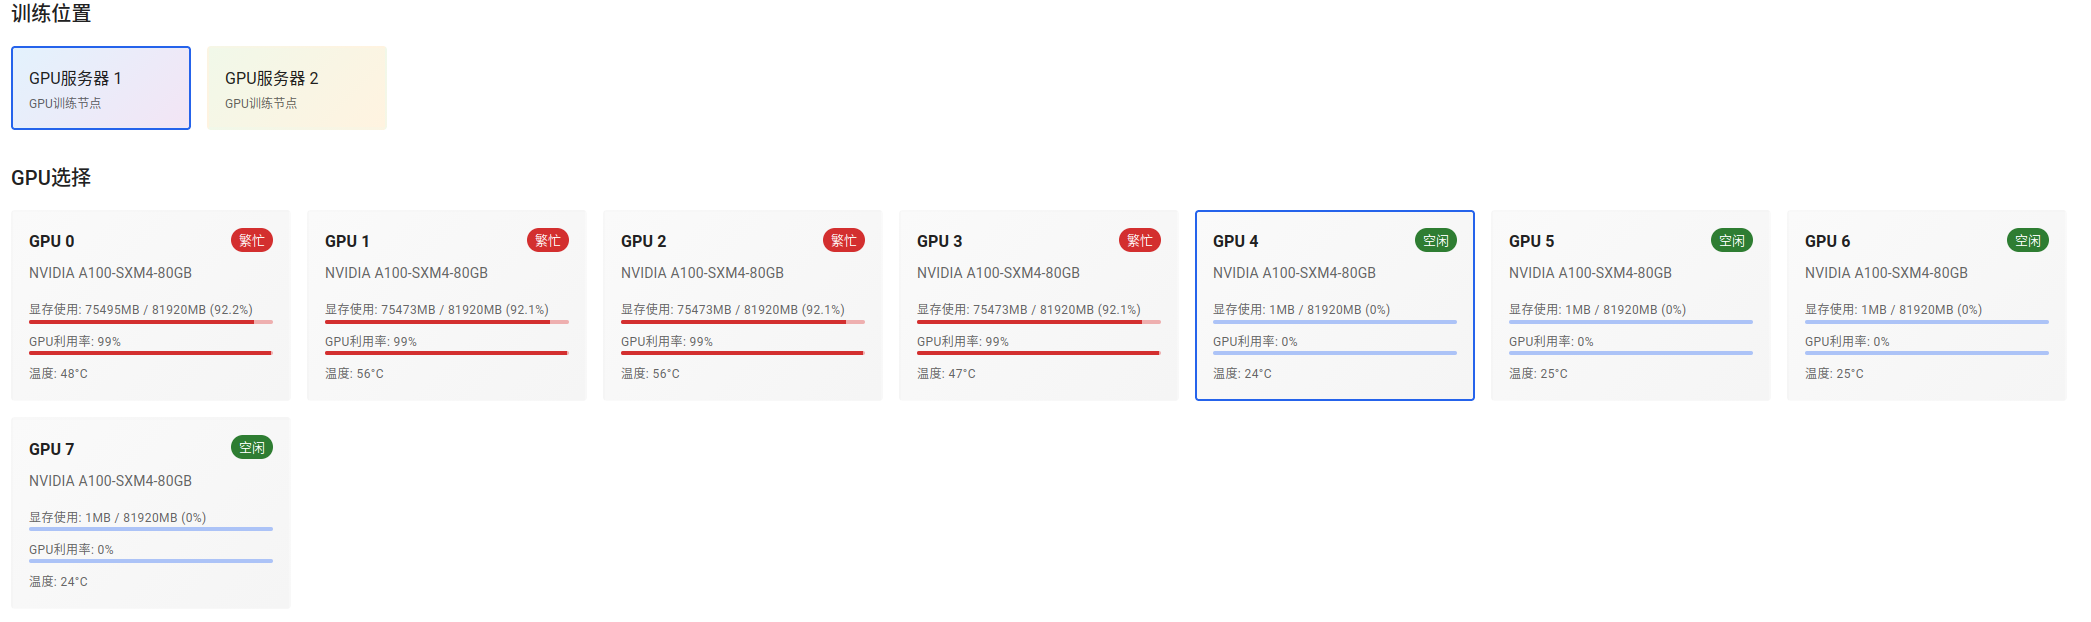
- 公有云资源 :按需租赁云服务商的算力资源,按实际训练时长计费
- RunPod:租赁GPU容器进行快速部署,适合临时性训练任务或资源扩展需求
- 其他云服务商支持(暂未开通)
- 私有云算力: 仅适用于项目进行私有化部署的情况
GPU选择与监控:
- 训练前可查看可用GPU列表及实时状态
- 支持手动选择特定GPU或多GPU并行
- 实时监控GPU利用率、显存占用、温度等信息
- 自动优化显存分配,避免资源浪费
训练配额管理
训练配额用于控制资源使用,确保系统资源合理分配。
配额类型:
- 用户配额:每个用户有独立的训练配额限制
- 全局配额:系统级别的总配额限制(管理员配置)
- 配额统计:实时显示已使用配额和剩余配额
配额显示:
- 训练页面显示当前用户的配额使用情况
- 显示已使用数量和总配额限制
- 超出配额时无法创建新的训练任务
配额管理(管理员):管理员可以
- 查看所有用户的训练配额使用情况
- 配置全局训练配额限制
- 调整单个用户的配额
6.3.3 配置参数并开始训练
平台提供了丰富的训练参数配置选项,支持不同模型的特定需求:
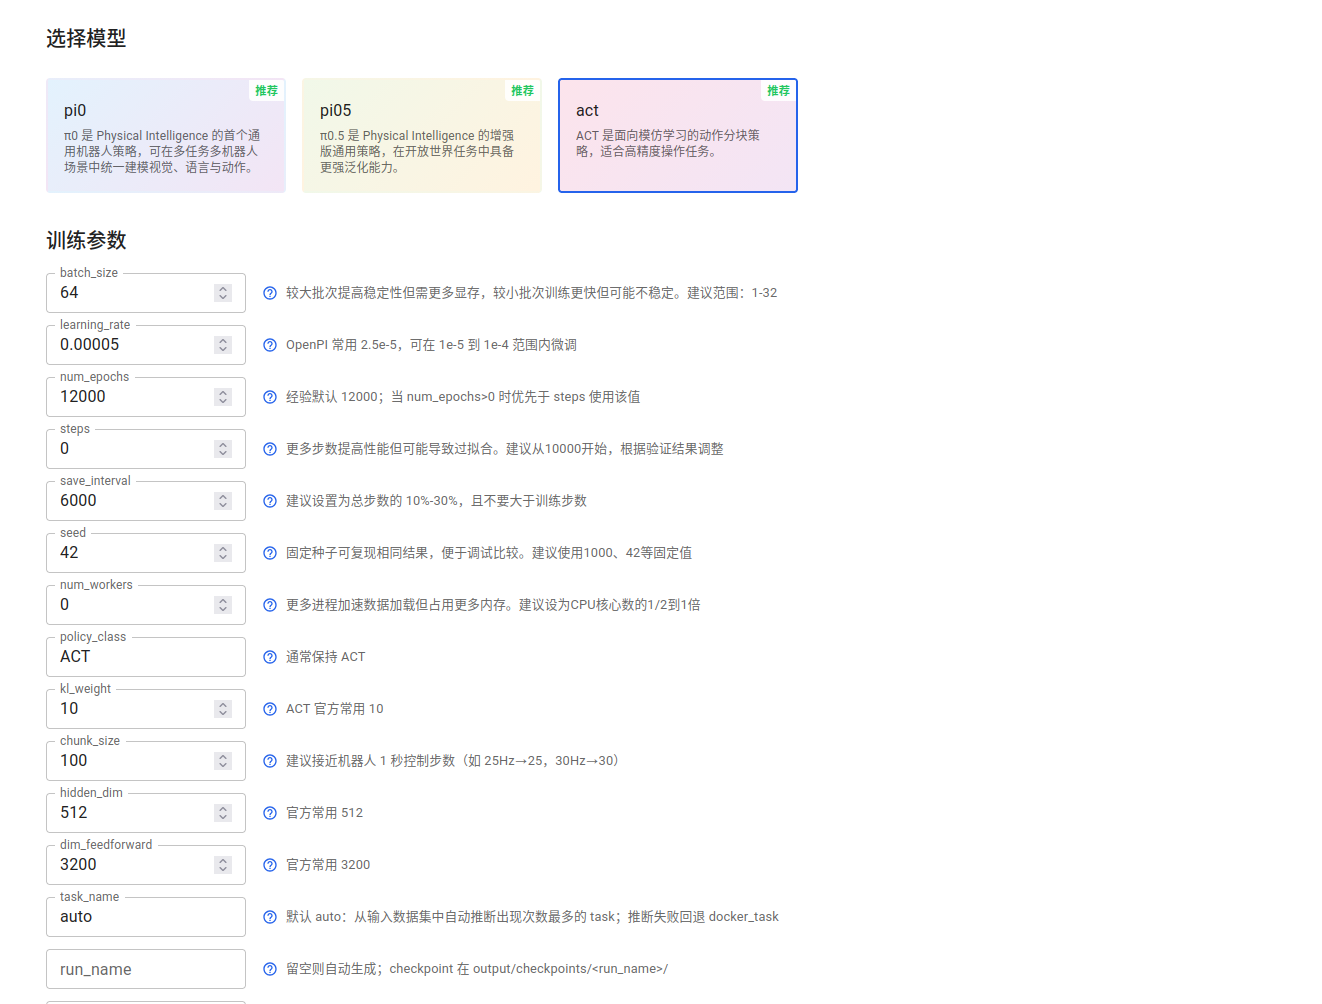
| 参数项 | 参数含义 | 设置建议 |
|---|---|---|
| 通用训练参数 | ||
| batch_size(批次大小) | 控制每次训练使用的样本数量 | 建议范围1-32,根据 GPU 显存调整。较大批次提高训练稳定性但需要更多显存 |
| steps(训练步数) | 模型训练的总步数 | 建议从10000开始,根据验证结果调整 |
| seed(随机种子) | 确保训练结果可重现性 | 建议使用1000、42等固定值 |
| num_workers(数据加载器工作进程数) | 加速数据加载 | 建议设为CPU核心数的1/2到1倍 |
| eval_freq(评估频率) | 每多少步进行一次模型评估 | 建议为总步数的10% |
| log_freq(日志频率) | 每多少步打印一次训练日志 | 建议10到100步 |
| save_freq(保存频率) | 每多少步保存一次检查点 | 建议为总步数的30% |
| save_checkpoint(是否保存检查点) | 开启后保存模型检查点,便于恢复训练或部署 | |
| optimizer_lr(学习率) | 控制参数更新幅度 | 建议范围1e-4到1e-5。过大导致训练不稳定,过小收敛慢。 |
| optimizer_weight_decay(权重衰减) | 防止过拟合的正则化参数 | 建议范围0.0到0.01 |
| optimizer_grad_clip_norm(梯度裁剪阈值) | 防止梯度爆炸 | 建议设置为1.0 |
| scheduler_warmup_steps(学习率预热步数) | 训练初期逐步增加学习率 | 建议为总步数的5-10% |
| scheduler_decay_steps(学习率衰减步数) | 在训练后期降低学习率 | 建议为总步数的80-90% |
| 模型特定参数:不同模型支持各自的特定参数 | ||
| ACT模型: | ||
chunk_size(动作块大小) | 一次预测的动作序列长度 | 建议范围10-50 |
n_obs_steps(观测历史步数) | 使用的历史观测帧数 | 大部分情况使用1 |
n_action_steps(执行步数) | 实际执行的动作步数 | 通常等于chunk_size |
vision_backbone(视觉 backbone) | 可选resnet18/34/50/101/152 | |
dim_model(模型维度) | Transformer的主要隐藏维度 | 默认512 |
n_heads(注意力头数) | Multi-head attention的头数 | 默认8 |
| Diffusion Policy模型 | ||
horizon(预测时间跨度) | 扩散模型的动作预测长度 | 建议16 |
num_inference_steps(推理步数) | 采样步数 | 建议10 |
| SmolVLA/OpenVLA模型 | ||
max_input_seq_len(最大输入序列长度) | 限制输入token数量 | 建议256-512 |
max_decoding_steps(最大解码步数) | 生成动作序列的最大迭代次数 | 建议256 |
freeze_lm_head(冻结语言模型头部) | 微调时建议开启 | |
freeze_vision_encoder(冻结视觉编码器) | 微调时建议开启 | |
| SAC等强化学习模型: | ||
latent_dim(潜在空间维度) | 编码器输出维度 | 建议256 |
参数设置建议:
- 首次训练建议使用默认参数,确保训练正常进行
- 根据GPU显存大小调整batch_size,避免显存溢出
- 对于预训练模型微调,建议降低学习率(1e-5)并冻结部分层
- 定期查看训练日志,根据损失曲线调整学习率
配置完成后,点击"开始训练"即可。
6.3.4 训练执行与监控
6.3.4.1 实时监控
训练启动后,平台提供完整的实时监控功能:
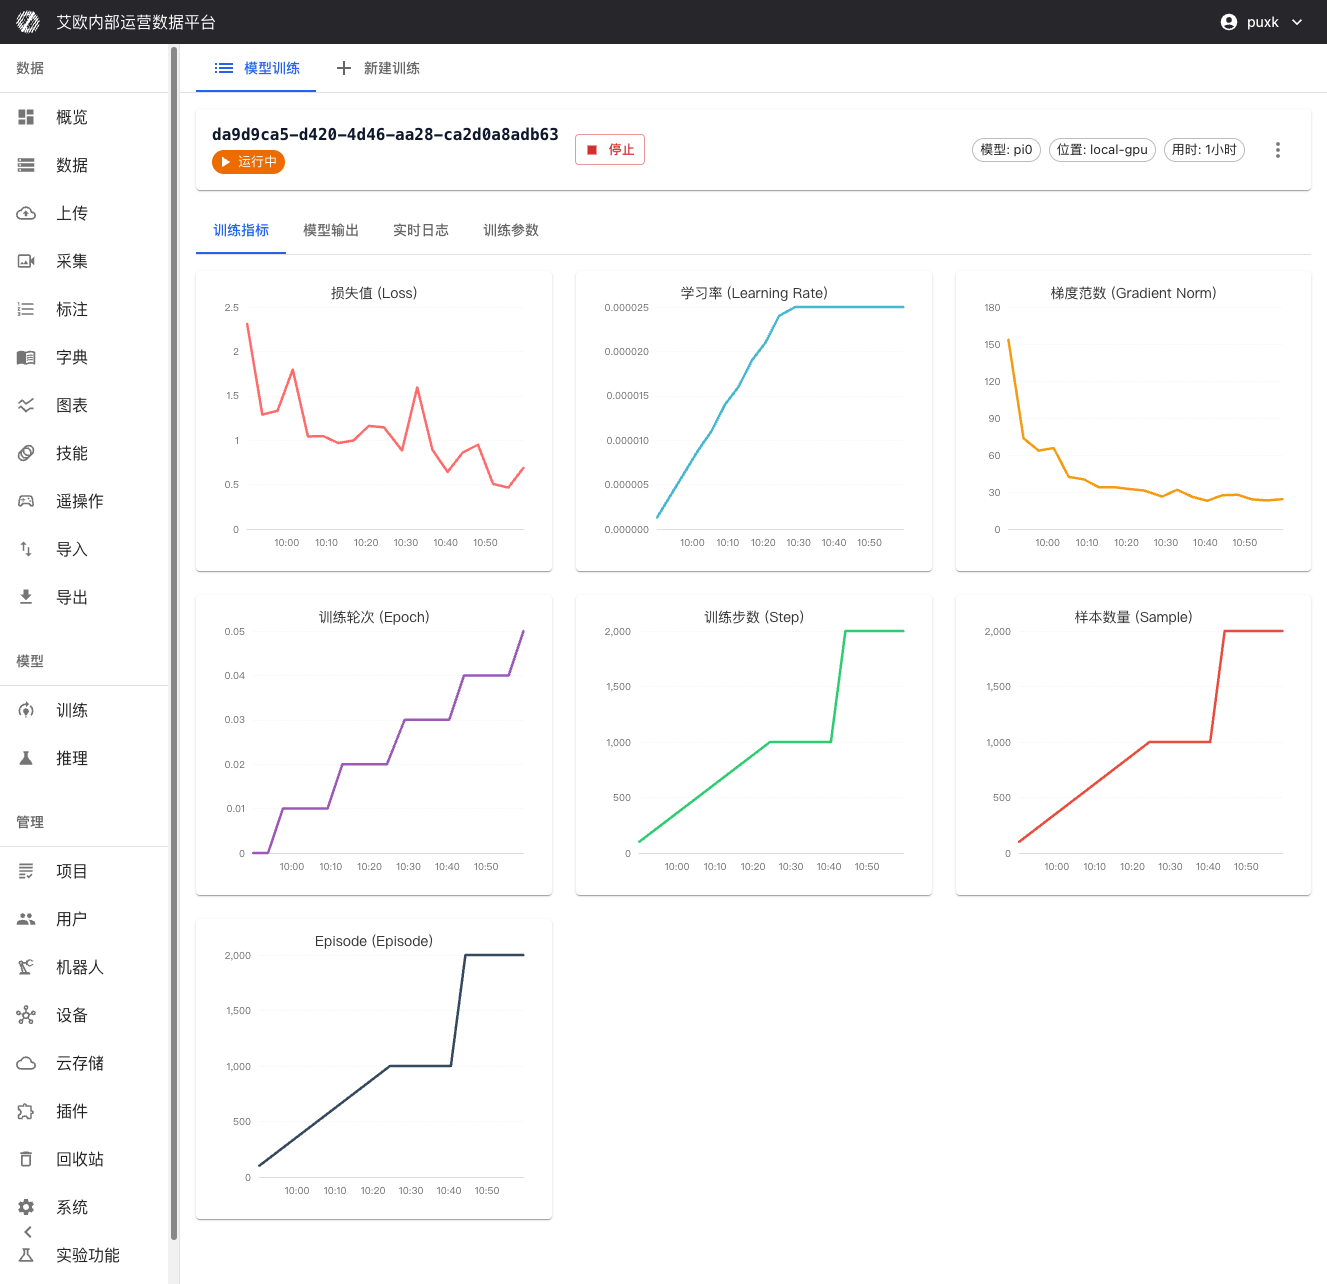
| 功能类别 | 功能项 | 功能介绍 |
|---|---|---|
| 实时监控 | 训练指标可视化: | - 损失函数曲线 - 实时显示训练损失和验证损失,便于判断模型收敛情况 - 验证精度指标 - 显示模型在验证集上的性能表现 - 学习率变化 - 可视化学习率调度策略的执行情况 - 训练进度 - 显示已完成步数、总步数、预计剩余时间等信息 |
| 模型输出预览: | - 训练过程中定期输出预测样例 - 可视化模型在验证数据上的预测结果 - 便于观察模型学习进展和发现潜在问题 | |
| 系统日志: | - 详细的训练日志记录,包括每个训练步骤的详细信息 - 错误和警告信息实时显示,便于快速定位问题 - 支持日志实时流式传输,可随时查看最新训练状态 | |
| 资源监控: | - GPU利用率、显存占用实时监控 - CPU和内存使用情况跟踪 - 网络IO和磁盘IO监控(如适用) |
- 定期检查训练日志,及时发现问题
- 根据损失曲线调整学习率或停止训练
- 定期保存检查点,避免训练中断导致数据丢失
- 使用任务复制功能快速尝试不同的参数组合
- 一般情况下判断模型是否可以使用的方式是:损失值(Loss)<0.1。
6.3.4.2 检查点管理
同时产品还提供了检查点管理功能。我们建议您定期保存检查点,避免训练中断导致数据丢失。
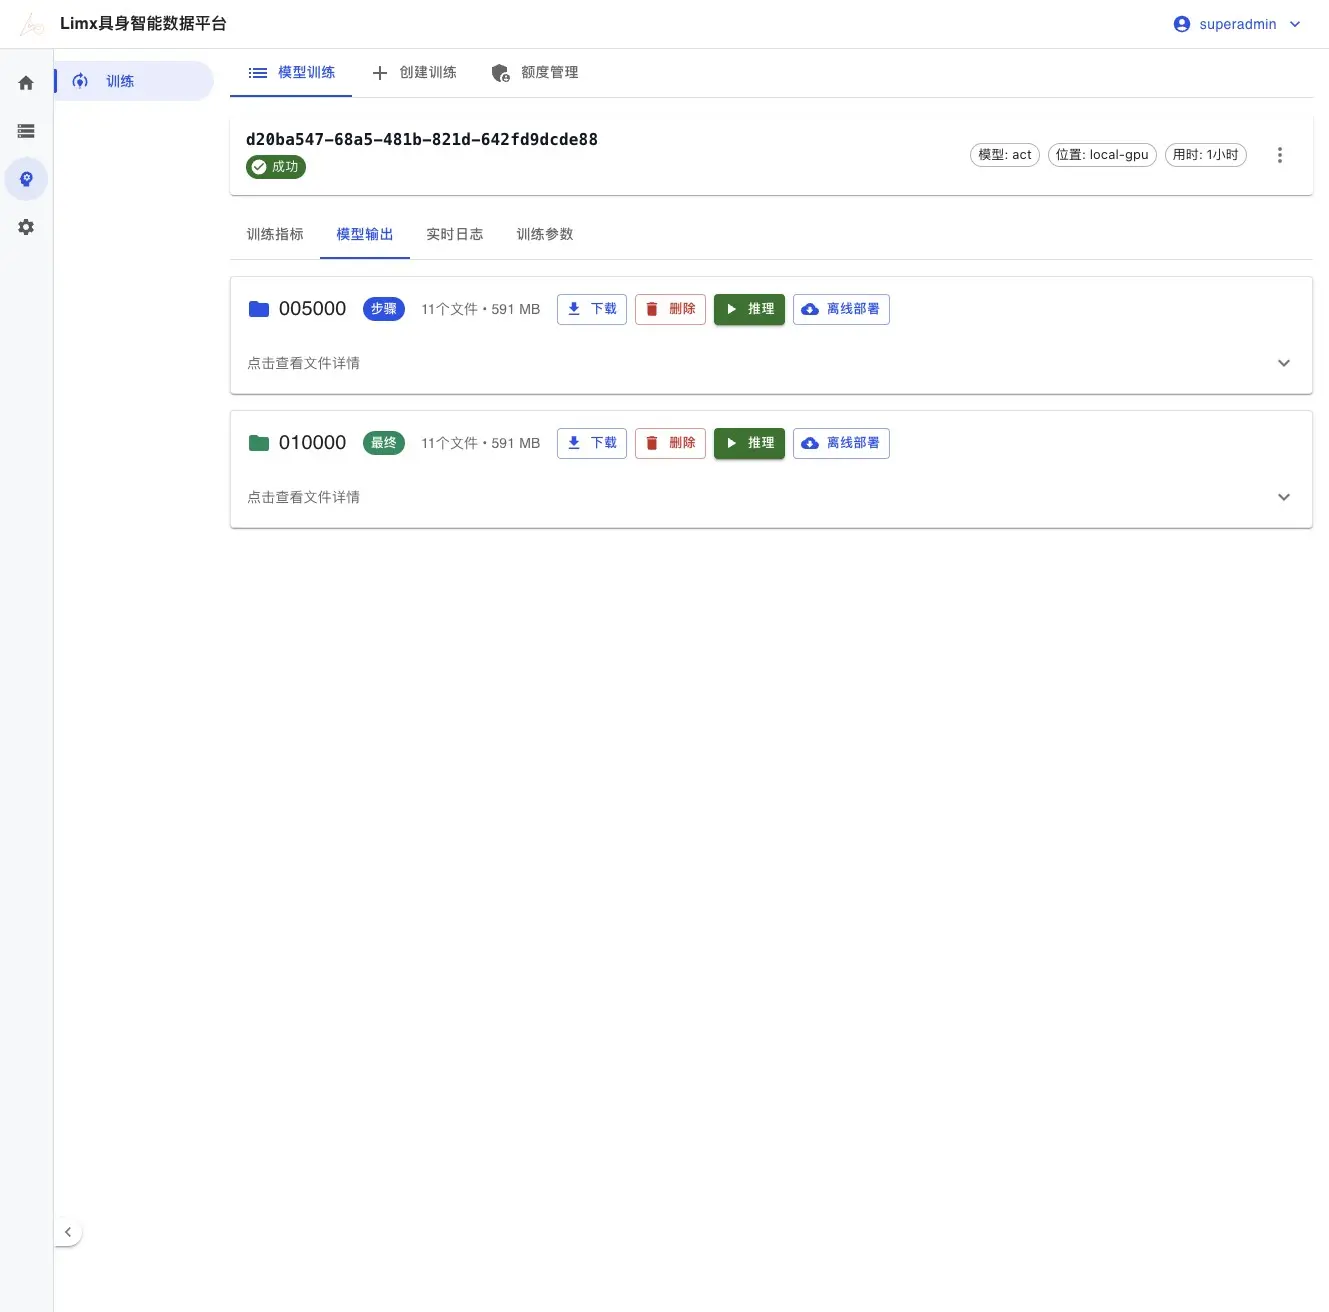
检查点说明:
- last:最后一个保存的检查点,通常是最新的模型状态
- best:在验证集上表现最好的检查点,通常用于生产部署
- step_xxx:按训练步数保存的检查点,可用于分析训练过程
| 功能类别 | 功能项 | 功能介绍 |
|---|---|---|
| 检查点管理 | 进程控制: | - 暂停训练 - 临时暂停训练任务,保留当前进度 - 恢复训练 - 从暂停点恢复训练,无缝继续 - 停止训练 - 安全停止训练任务,保存当前检查点 - 重启训练 - 重新启动训练任务 |
| 检查点管理: | - 自动保存 - 根据设置的保存频率自动保存模型检查点 - 检查点列表 - 查看所有保存的检查点,包括训练步数、保存时间等信息 - 检查点下载 - 支持下载检查点文件到本地 - 断点续训 - 从任意检查点恢复训练,支持训练中断后的继续 - 版本回滚 - 可选择历史检查点进行模型回滚 | |
| 检查点信息: | - 检查点名称:自动生成或自定义的检查点名称(如"step_1000"、"last"等) - 训练步数:该检查点对应的训练步数 - 保存时间:检查点的保存时间戳 - 文件大小:检查点文件的大小 - 性能指标:该检查点在验证集上的性能表现 | |
| 检查点操作: | - 查看详情:查看检查点的详细信息和评估结果 - 下载检查点:下载检查点文件到本地,用于离线部署或进一步分析 - 标记为最佳:将性能最好的检查点标记为最佳模型 - 部署推理:直接从检查点一键部署为推理服务 | |
| 任务操作: | - 参数调整 - 训练过程中可查看和调整部分训练参数(需谨慎使用) - 任务复制 - 基于成功的训练配置快速创建新任务,复用最佳配置 - 任务删除 - 删除不需要的训练任务,释放存储空间 |
6.3.4.3 从失败的训练中恢复
至此,您可以利用具身数据平台方便快捷的训练出属于您的专属模型。训练完成的模型检查点可以直接在下一章节进行推理服务部署,实现从训练到应用的全流程闭环。
但是如果训练任务失败,您可以:
1.查看错误信息:在训练详情页面查看详细的错误日志 2.分析失败原因:常见原因包括: - 显存不足:降低 batch_size 或使用更大的 GPU - 数据格式错误:检查数据格式是否符合要求 - 参数配置错误:检查参数设置是否合理 3.修改参数:在训练详情页面点击"修改参数",调整配置后重新训练 4.从检查点恢复:如果之前保存了检查点,可以从检查点继续训练
6.3.5 模型评估与导出
训练完成后,平台提供完整的模型评估、导出和部署功能:
| 功能类别 | 功能项 | 功能介绍 |
|---|---|---|
| 模型评估 | 性能指标: | - 自动计算模型在验证集上的各项性能指标 - 支持多种评估指标:准确率、成功率、动作误差等 - 提供模型性能报告和对比分析 |
| 模型对比: | - 对比不同训练任务的模型性能 - 可视化多个模型指标的对比图表 - 帮助选择最佳性能的模型版本 | |
| 模型导出 | 模型导出 | 训练完成后,可以将模型导出用于: - 离线部署到机器人本地 - 与其他系统集成 - 模型版本管理和归档 |
至此,您可以利用具身数据平台方便快捷的训练出属于您的专属模型。