Platform · dictionaries & export
This page has not been translated and displays the Chinese reference. Navigation and search are available in English. Operational details must be checked against the applicable manual.
5.6 字典管理
5.6.1 功能概述
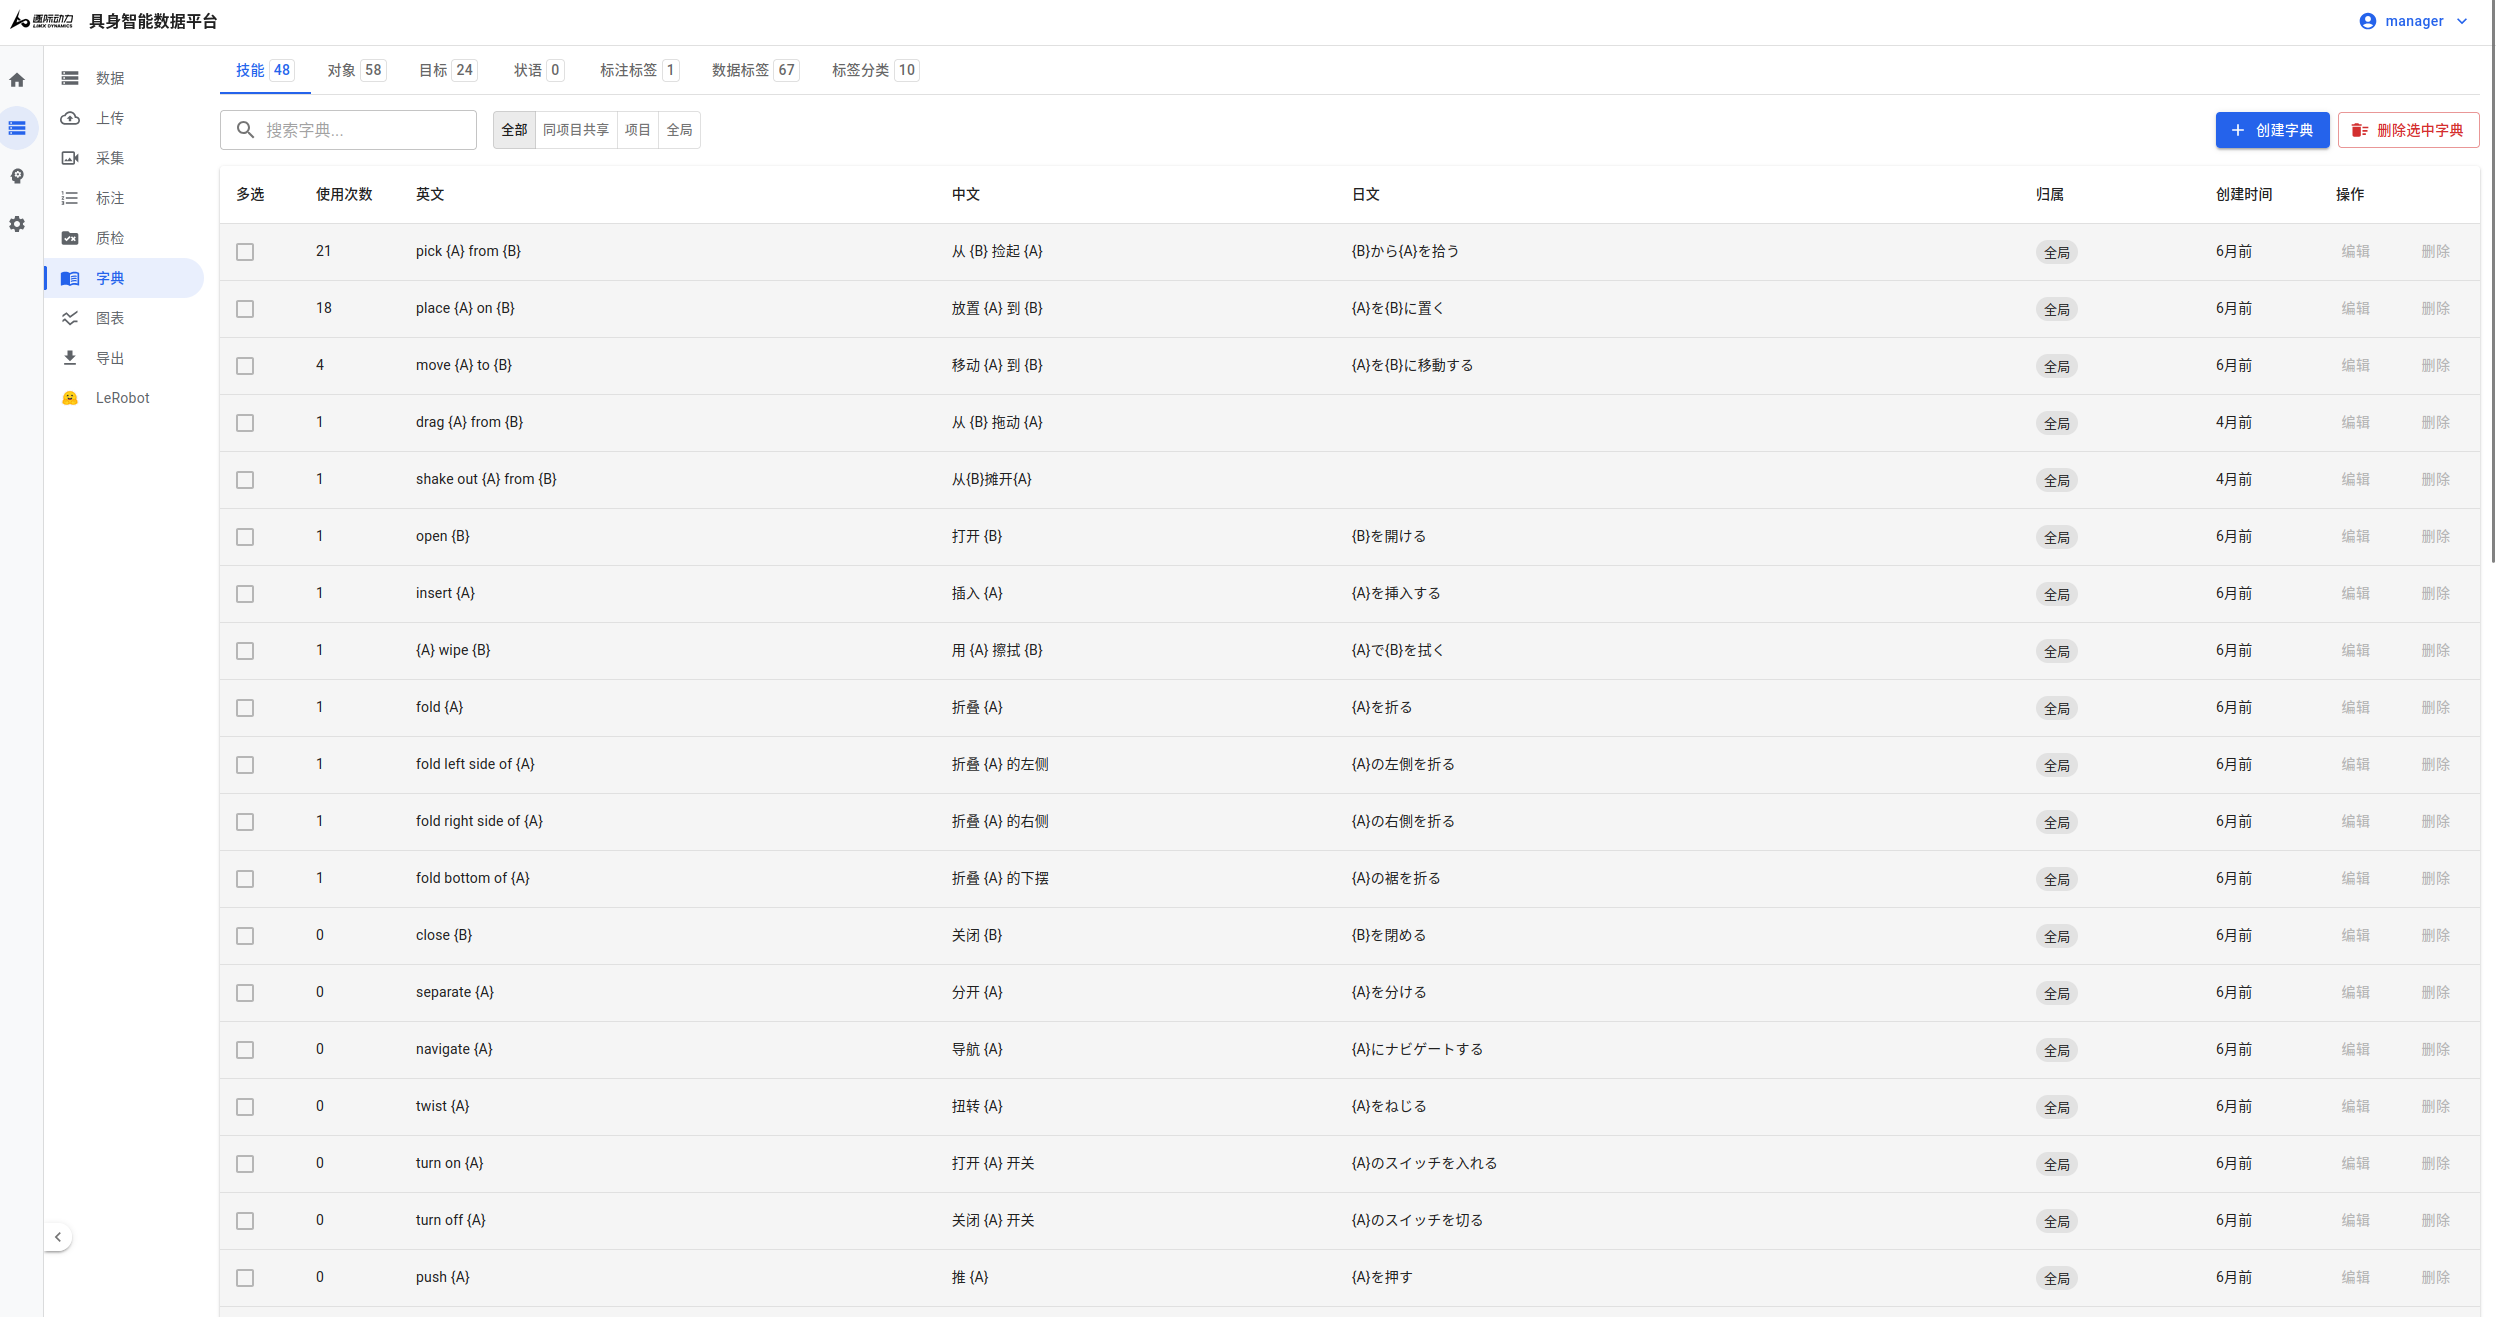
统一维护技能、对象、目标、状语、标注标签、数据标签等字典,确保不同项目遵循一致的命名与口径,支持多语言与批量操作。
5.6.2 适用角色和场景
| 角色 | 职责 |
|---|---|
| 管理员 | 作为平台管理员,您可以制定并维护字典标准,管理所有类型的字典内容,配置多语言支持,并监控字典的使用情况。这些功能确保平台的标准化体系稳定运行。 |
| 项目经理 | 项目经理可以管理项目相关的字典内容,确保项目团队使用统一的标注标准,并根据项目需求调整字典配置。通过字典管理,项目经理能够有效控制项目的标注质量。 |
| 标注员 | 标注员可以在标注过程中引用统一的字典,减少标注歧义,提高标注效率。字典为标注员提供了标准化的参考,确保标注结果的一致性和准确性。 |
| 审核员 | 审核员可以基于统一的字典标准进行审核,确保标注结果符合规范要求。字典为审核员提供了明确的审核依据,提高了审核效率和准确性。 |
5.6.3 主要功能
5.6.3.1 字典类型管理
技能字典
管理所有标注技能的定义和分类,包括技能名称、描述、使用场景、难度等级等信息。通过技能字典,确保团队成员对技能的理解一致,减少标注过程中的歧义。
对象字典
维护标注中涉及的各种对象类型,如物品、人物、场景等。对象字典帮助标注员快速识别和分类不同的标注目标,提高标注效率和准确性。
标签字典
统一管理标注标签和数据标签,包括标签名称、颜色、层级关系等。通过标签字典,确保标签使用的一致性和规范性。
5.6.3.2 多语言支持
国际化管理
支持多种语言的字典管理,包括中文、英文等。管理员可以为不同语言环境配置相应的字典内容,确保国际化项目的顺利进行。
翻译管理
提供字典内容的翻译功能,支持批量翻译和人工校对。通过翻译管理,确保不同语言版本的字典内容准确一致。
5.6.3.3 批量操作功能
批量导入
支持从Excel、CSV等文件批量导入字典数据,大大提高了字典维护效率。导入过程中会自动进行数据验证,确保数据的准确性。
批量编辑
提供批量编辑功能,可以同时修改多个字典项,支持查找替换、批量更新等操作。这些功能让字典维护工作更加高效。
批量导出
支持将字典数据导出为各种格式,便于备份、分享或与其他系统集成。导出的数据保持完整的结构和格式。
5.6.3.4 版本控制
变更历史
记录字典的所有变更历史,包括修改时间、修改人、修改内容等。通过变更历史,可以追踪字典的演进过程。
版本回滚
支持将字典回滚到历史版本,当发现当前版本有问题时,可以快速恢复到之前的稳定版本。
变更审批
提供变更审批流程,重要字典的修改需要经过审批才能生效,确保字典变更的规范性和安全性。
5.7 数据导出
5.7.1 功能概述
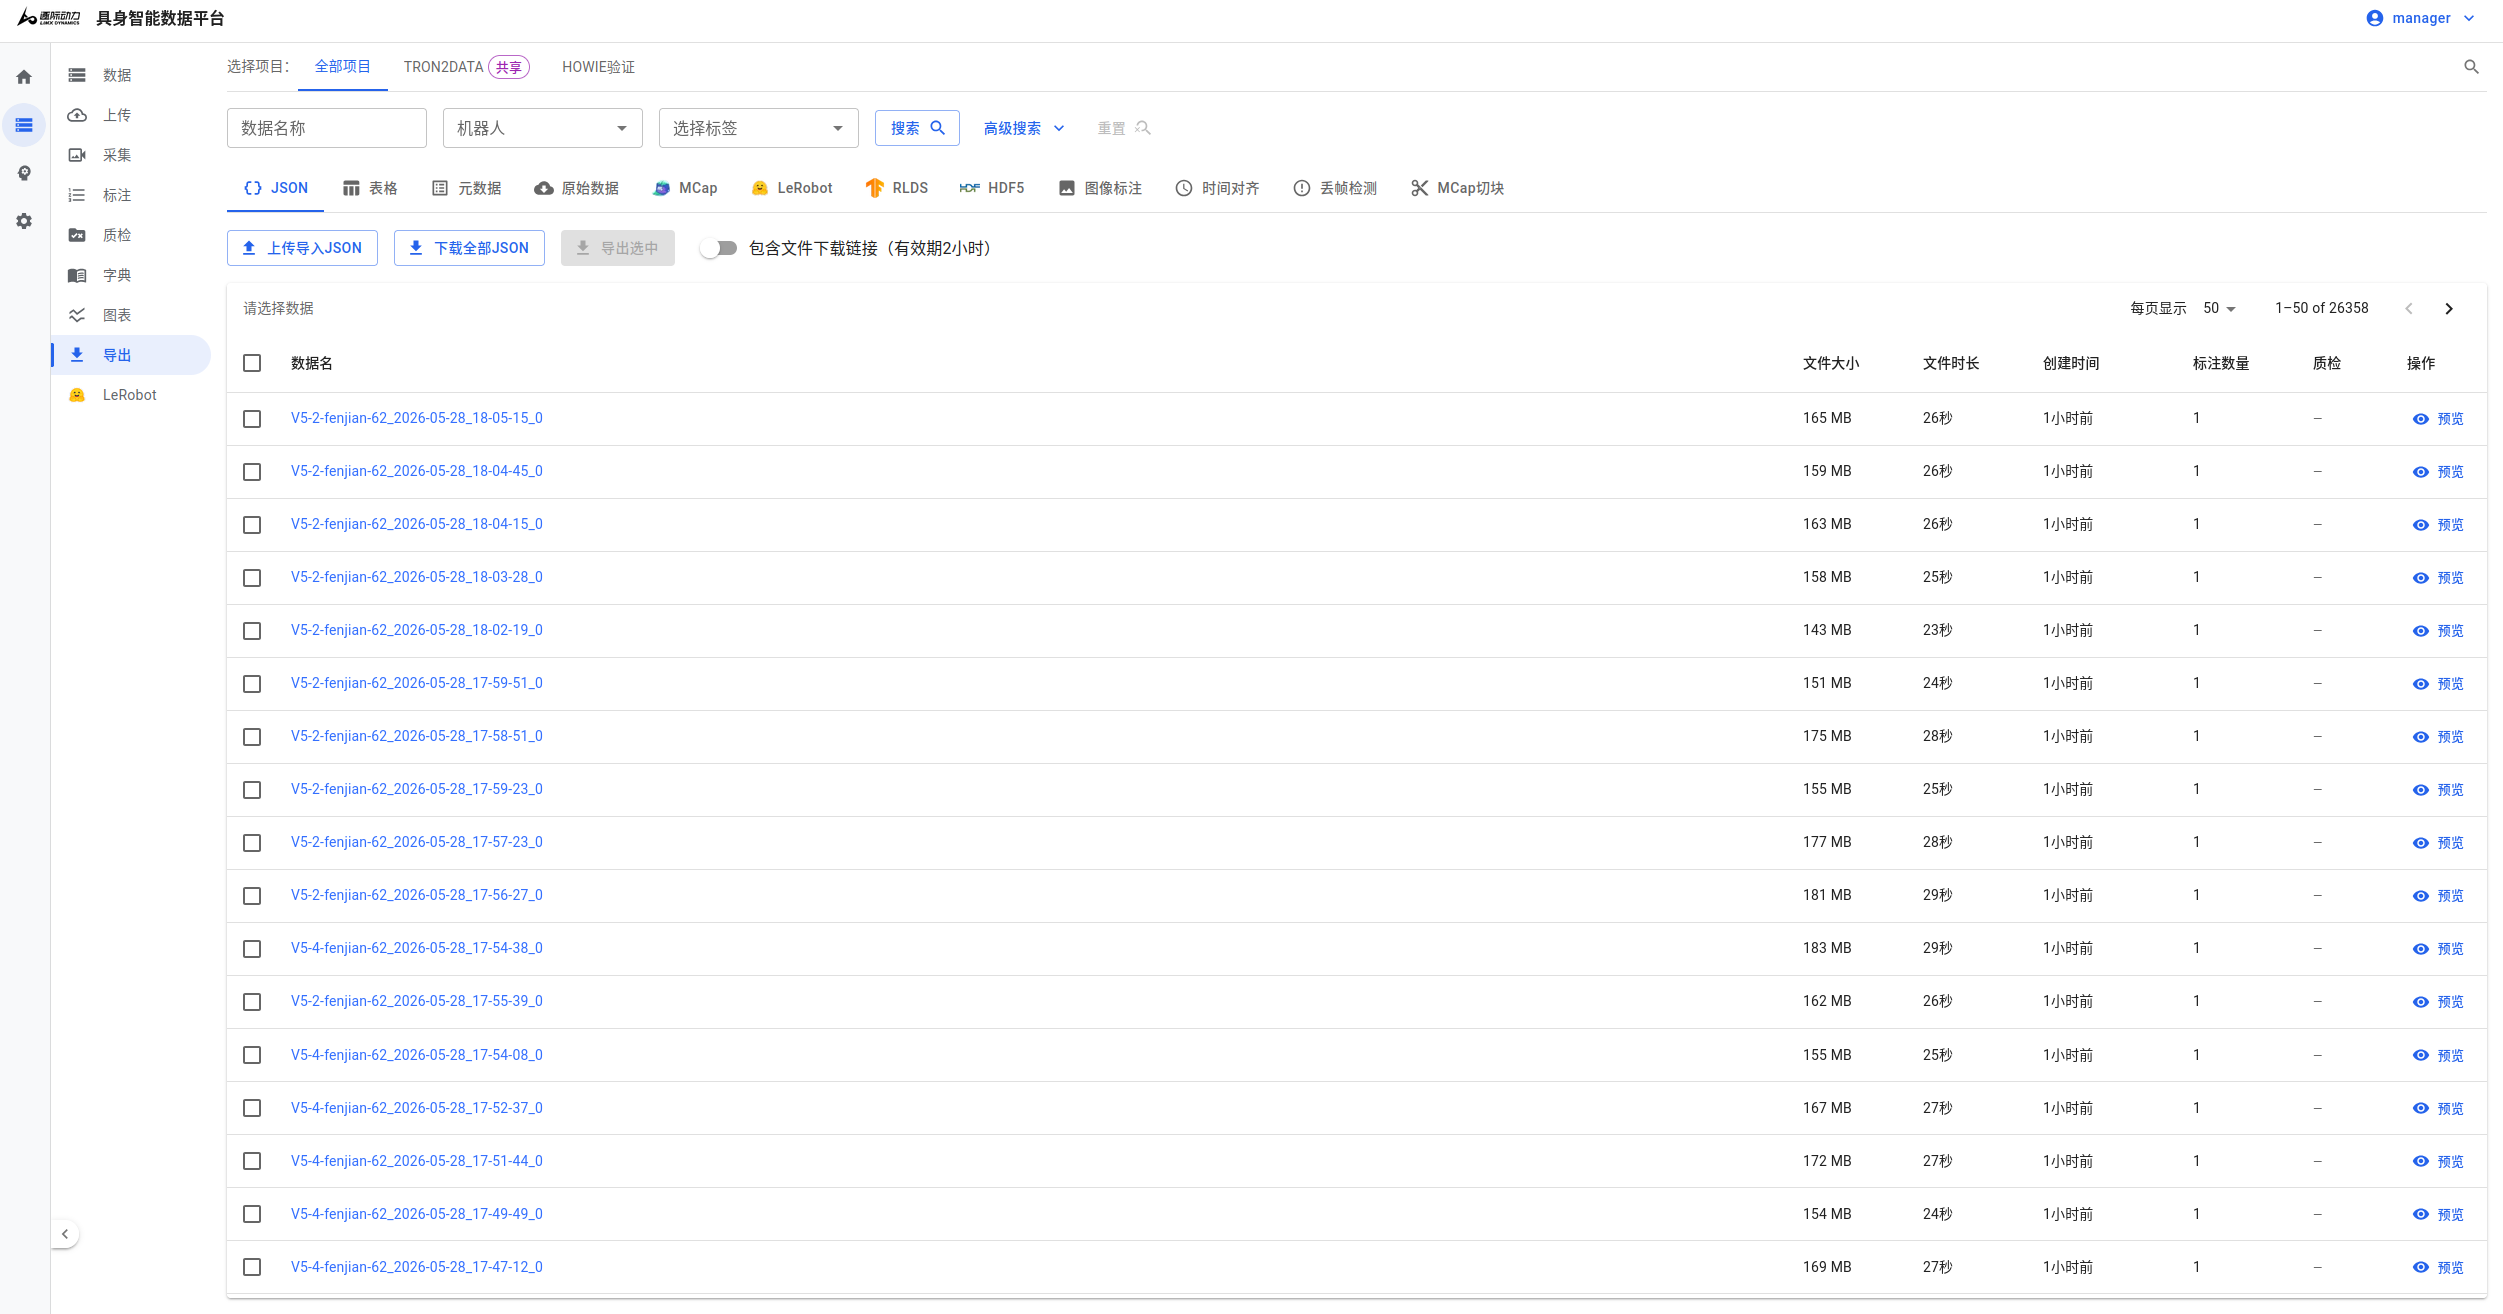
数据导出是具身数据平台的重要数据交付模块,提供将已标注数据导出为多种标准格式的功能,包括 JSON、CSV、HDF5、LeRobot、MCap 等。通过灵活的筛选条件、批量导出功能和导出历史管理,确保标注数据能够以最适合的格式交付给下游系统,支持模型训练、数据分析等各种应用场景。
5.7.2 适用角色
| 角色 | 职责 |
|---|---|
| 管理员 | 作为平台管理员,您可以对外交付训练数据或下游分析所需数据,管理导出任务,监控导出进度,并控制数据导出权限。这些功能确保平台的数据交付服务安全高效。 |
| 项目经理 | 项目经理可以导出项目相关的数据,为项目交付准备数据,监控数据使用情况,并协调数据导出工作。通过数据导出管理,项目经理能够有效控制项目的数据交付。 |
5.7.3 主要功能
5.7.3.1 多格式导出支持
- 标准数据格式
支持导出为多种标准数据格式,包括 JSON(结构化数据)、CSV(表格数据)、HDF5(科学计算数据)、LeRobot(机器人学习数据)、MCap(多模态数据)等。这些格式覆盖了绝大多数下游应用的需求。
- 自定义格式
支持根据特定需求自定义导出格式,包括字段选择、数据转换、格式配置等。通过自定义格式,可以满足特殊场景的数据导出需求。
- 格式转换
提供智能的格式转换功能,可以将数据从一种格式转换为另一种格式,确保数据在不同系统间的兼容性。转换过程支持数据验证和质量检查。
5.7.3.2 灵活筛选功能
- 多维度筛选
支持按项目、时间、标注员、质量等级等多个维度进行数据筛选。通过灵活的筛选条件,可以精确选择需要导出的数据。
- 高级筛选
提供高级筛选功能,支持复杂的筛选条件组合,包括逻辑运算、范围筛选、模糊匹配等。高级筛选让您能够精确控制导出的数据范围。
- 预览功能
在导出前提供数据预览功能,可以查看筛选结果,确认导出的数据符合预期。预览功能避免了不必要的导出操作。
5.7.3.3 批量导出管理
- 批量处理
支持批量导出多个数据集,可以同时处理多个导出任务,大大提高导出效率。批量处理特别适合大量数据的导出场景。
- 任务队列
提供导出任务队列管理,支持多个导出任务的排队和执行。通过任务队列,可以有序地处理大量导出请求。
- 进度监控
实时监控导出进度,包括已完成数量、处理速度、预计完成时间等。通过进度监控,可以及时了解导出状态。
-
导出状态
- pending(待处理)- 导出任务已创建,等待执行
- processing(处理中)- 导出任务正在执行中
- completed(已完成)- 导出任务成功完成,文件已生成
- failed(失败)- 导出任务执行失败,可以查看错误信息
-
进度信息
- 实时显示导出进度百分比
- 显示已处理数据集数量和总数量
- 显示预计剩余时间
- 支持自动刷新进度状态
5.7.3.4 导出历史管理
- 历史记录
平台完整记录所有导出操作的历史,支持查看和管理所有导出任务:
-
记录信息:
- 导出时间 - 创建时间、开始时间、完成时间
- 导出格式 - 导出数据类型(HDF5、LeRobot、MCAP、JSON、CSV等)
- 数据量 - 包含的数据集数量和文件大小
- 操作人 - 执行导出操作的用户信息
- 导出状态 - 当前导出任务的状态(待处理、处理中、已完成、失败)
- 文件信息 - 导出文件名称、大小、存储位置
-
历史记录功能:
- 支持按时间、格式、状态等条件筛选导出记录
- 支持搜索特定导出任务
- 显示导出任务的详细信息,包括包含的数据集列表
- 支持查看导出任务的错误信息(如失败)
-
MCAP导出历史与进度
MCAP导出功能提供完整的历史记录和实时进度监控:
-
导出历史列表:
- 显示所有MCAP导出任务的列表
- 每个记录显示导出状态、创建时间、包含的数据集数量等信息
- 支持展开查看详细信息和包含的数据集列表
- 支持按状态、时间等条件筛选
-
实时进度跟踪:
- 状态监控 - 实时更新导出任务状态(pending → processing → completed/failed)
- 进度显示 - 对于处理中的任务,显示实时进度条
- 自动刷新 - 系统自动检测任务状态变化并更新显示
- 错误处理 - 如果任务失败,显示详细错误信息
-
导出结果:
- 文件下载 - 导出完成后,可以直接下载生成的MCAP文件
- 文件信息 - 显示导出文件的大小、压缩格式等信息
- 存储位置 - 显示文件在云存储中的位置
- 训练集成 - 导出的MCAP文件可直接用于模型训练
-
HDF5导出功能
HDF5是一种高效的数据存储格式,平台提供了专门的HDF5导出功能:
-
导出配置:
-
分组数量(chunk_size) - 设置每个HDF5文件包含的原始文件数量
- 设置为1表示每个原始文件对应一个HDF5文件(一一对应)
- 设置更大的值可以将多个文件合并到一个HDF5文件中
- 建议根据数据量和训练需求设置
-
数据刷新频率(hz) - 控制每秒数据采集次数,影响文件大小
- 默认30Hz,适用于大多数场景
- 可以降低频率以减少文件大小
- 提高频率可以获得更密集的采样
-
导出统计:
- 显示已选择的数据集数量
- 显示导出配额使用情况
- 显示导出进度和预计完成时间
-
导出结果:
- 导出的HDF5文件按原始文件分组命名(如
chunk_001.hdf5) - 文件自动压缩为tar.gz格式
- 支持直接下载或保存到云存储
- 导出的HDF5文件可直接用于模型训练
- 导出的HDF5文件按原始文件分组命名(如
-
MCAP导出建议:
- 导出大量数据时,建议分批导出以提高成功率
- 可以通过导出历史查看之前的导出记录
- 如果导出失败,可以查看错误信息并重新导出
- 导出的MCAP文件会自动压缩为tar.gz格式以节省空间
HDF5导出详细说明:
- HDF5文件采用分层结构组织数据,支持多模态数据存储
- 导出后的HDF5文件包含完整的标注信息(任务描述、动作序列等)
- 版本管理
支持导出数据的版本管理,可以保存不同版本的导出结果,便于数据回溯和比较。版本管理确保数据的可追溯性。
- 权限控制
提供细粒度的权限控制,可以设置不同用户对不同数据的导出权限。通过权限控制,确保数据安全,防止未授权导出。
-
导出配额管理
- 系统支持导出配额限制,防止资源滥用
- 显示当前用户的导出配额使用情况
- 管理员可以配置全局导出配额限制
- 超出配额时会提示并阻止导出操作
5.7.4 工作流程
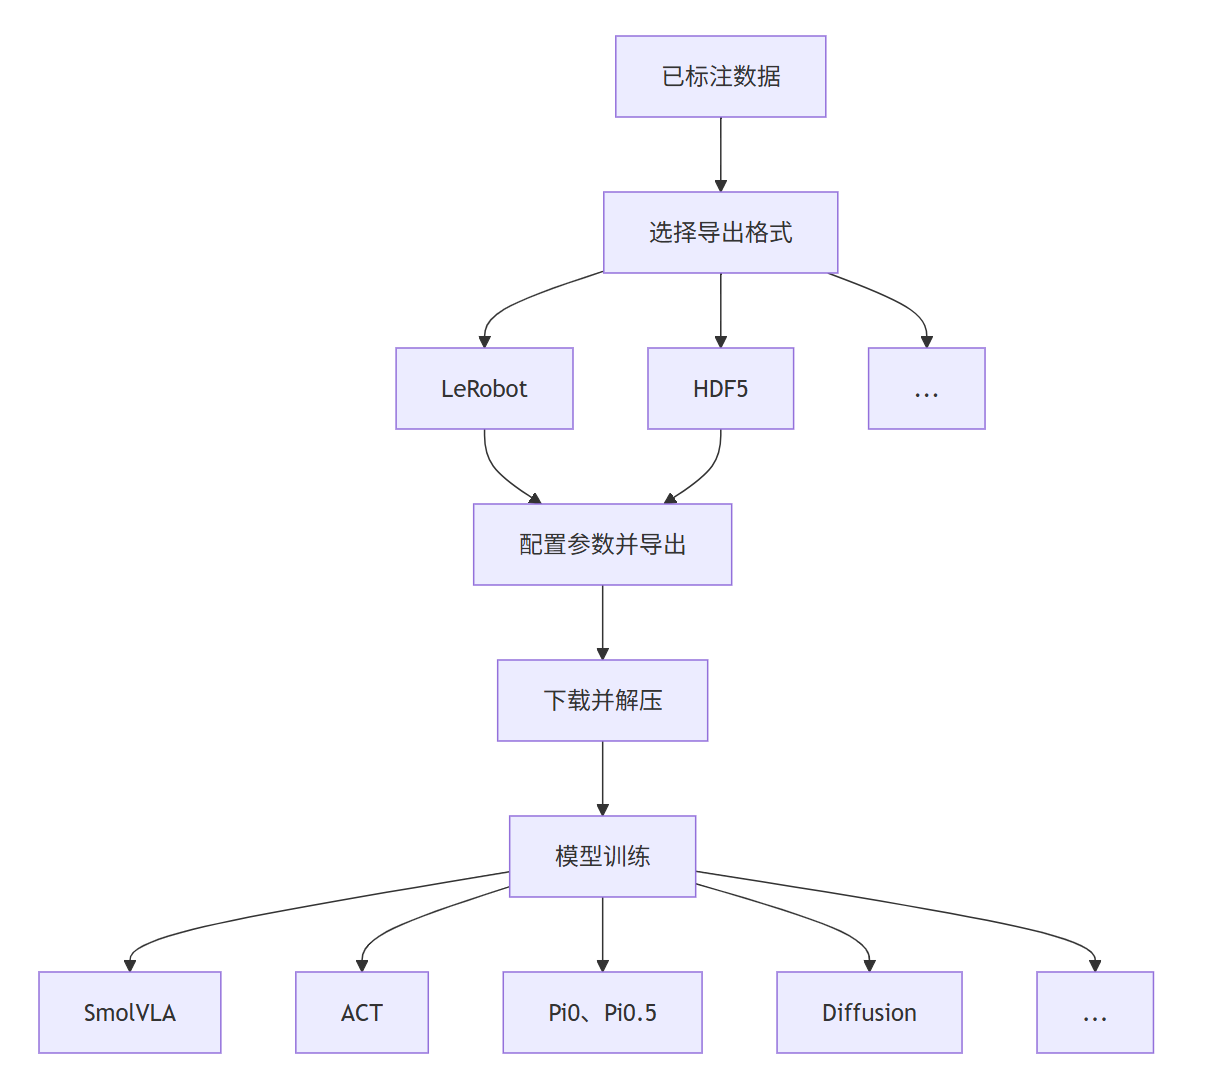
下图概括了从已标注数据到模型训练的链路:选择导出格式并配置参数,导出后下载解压,即可用于训练模型。
5.7.4.1 导出为HDF5数据集
HDF5(Hierarchical Data Format version 5)是一种高效、灵活的数据存储格式,广泛应用于具身智能领域。其分层结构(组和数据集)便于组织和管理多模态复杂数据,支持高效的数据读写和跨平台共享。
平台支持将mcap、bag、hdf5等格式的数据标注后导出为HDF5文件,便于后续模型训练。标注过程将动作与自然语言指令关联,确保VLA模型能够理解并执行语言命令。
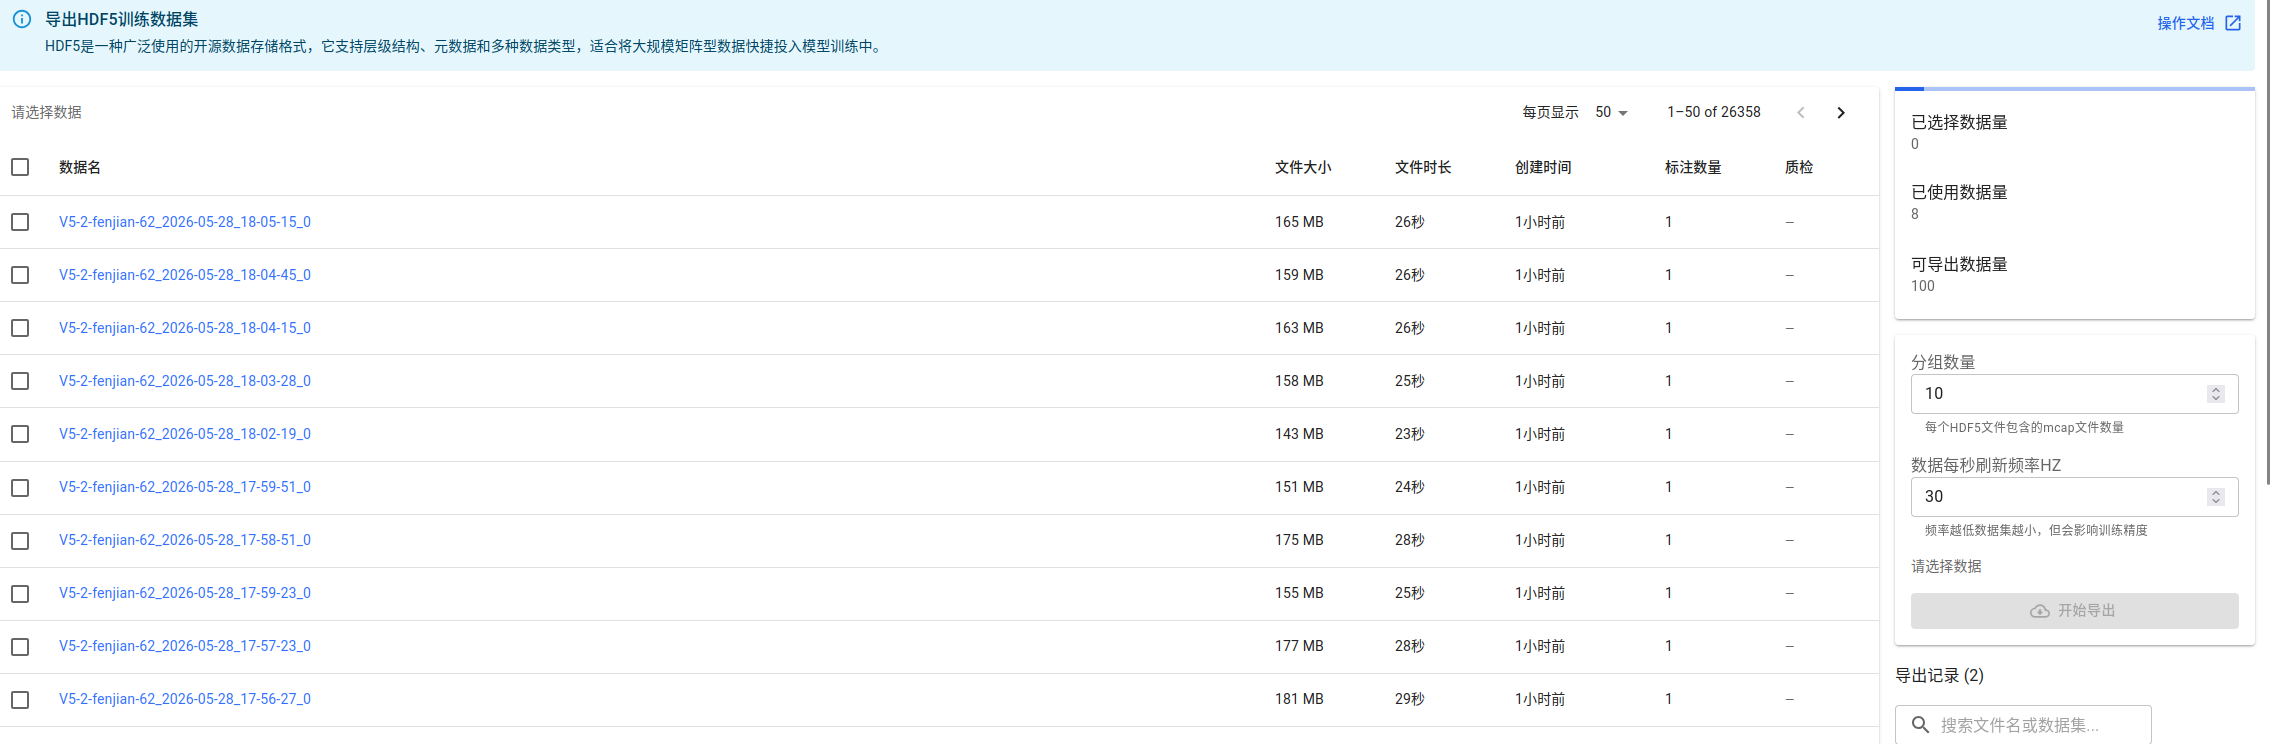
1.数据导出
标注完成后,可在导出界面选择所需数据子集进行导出。
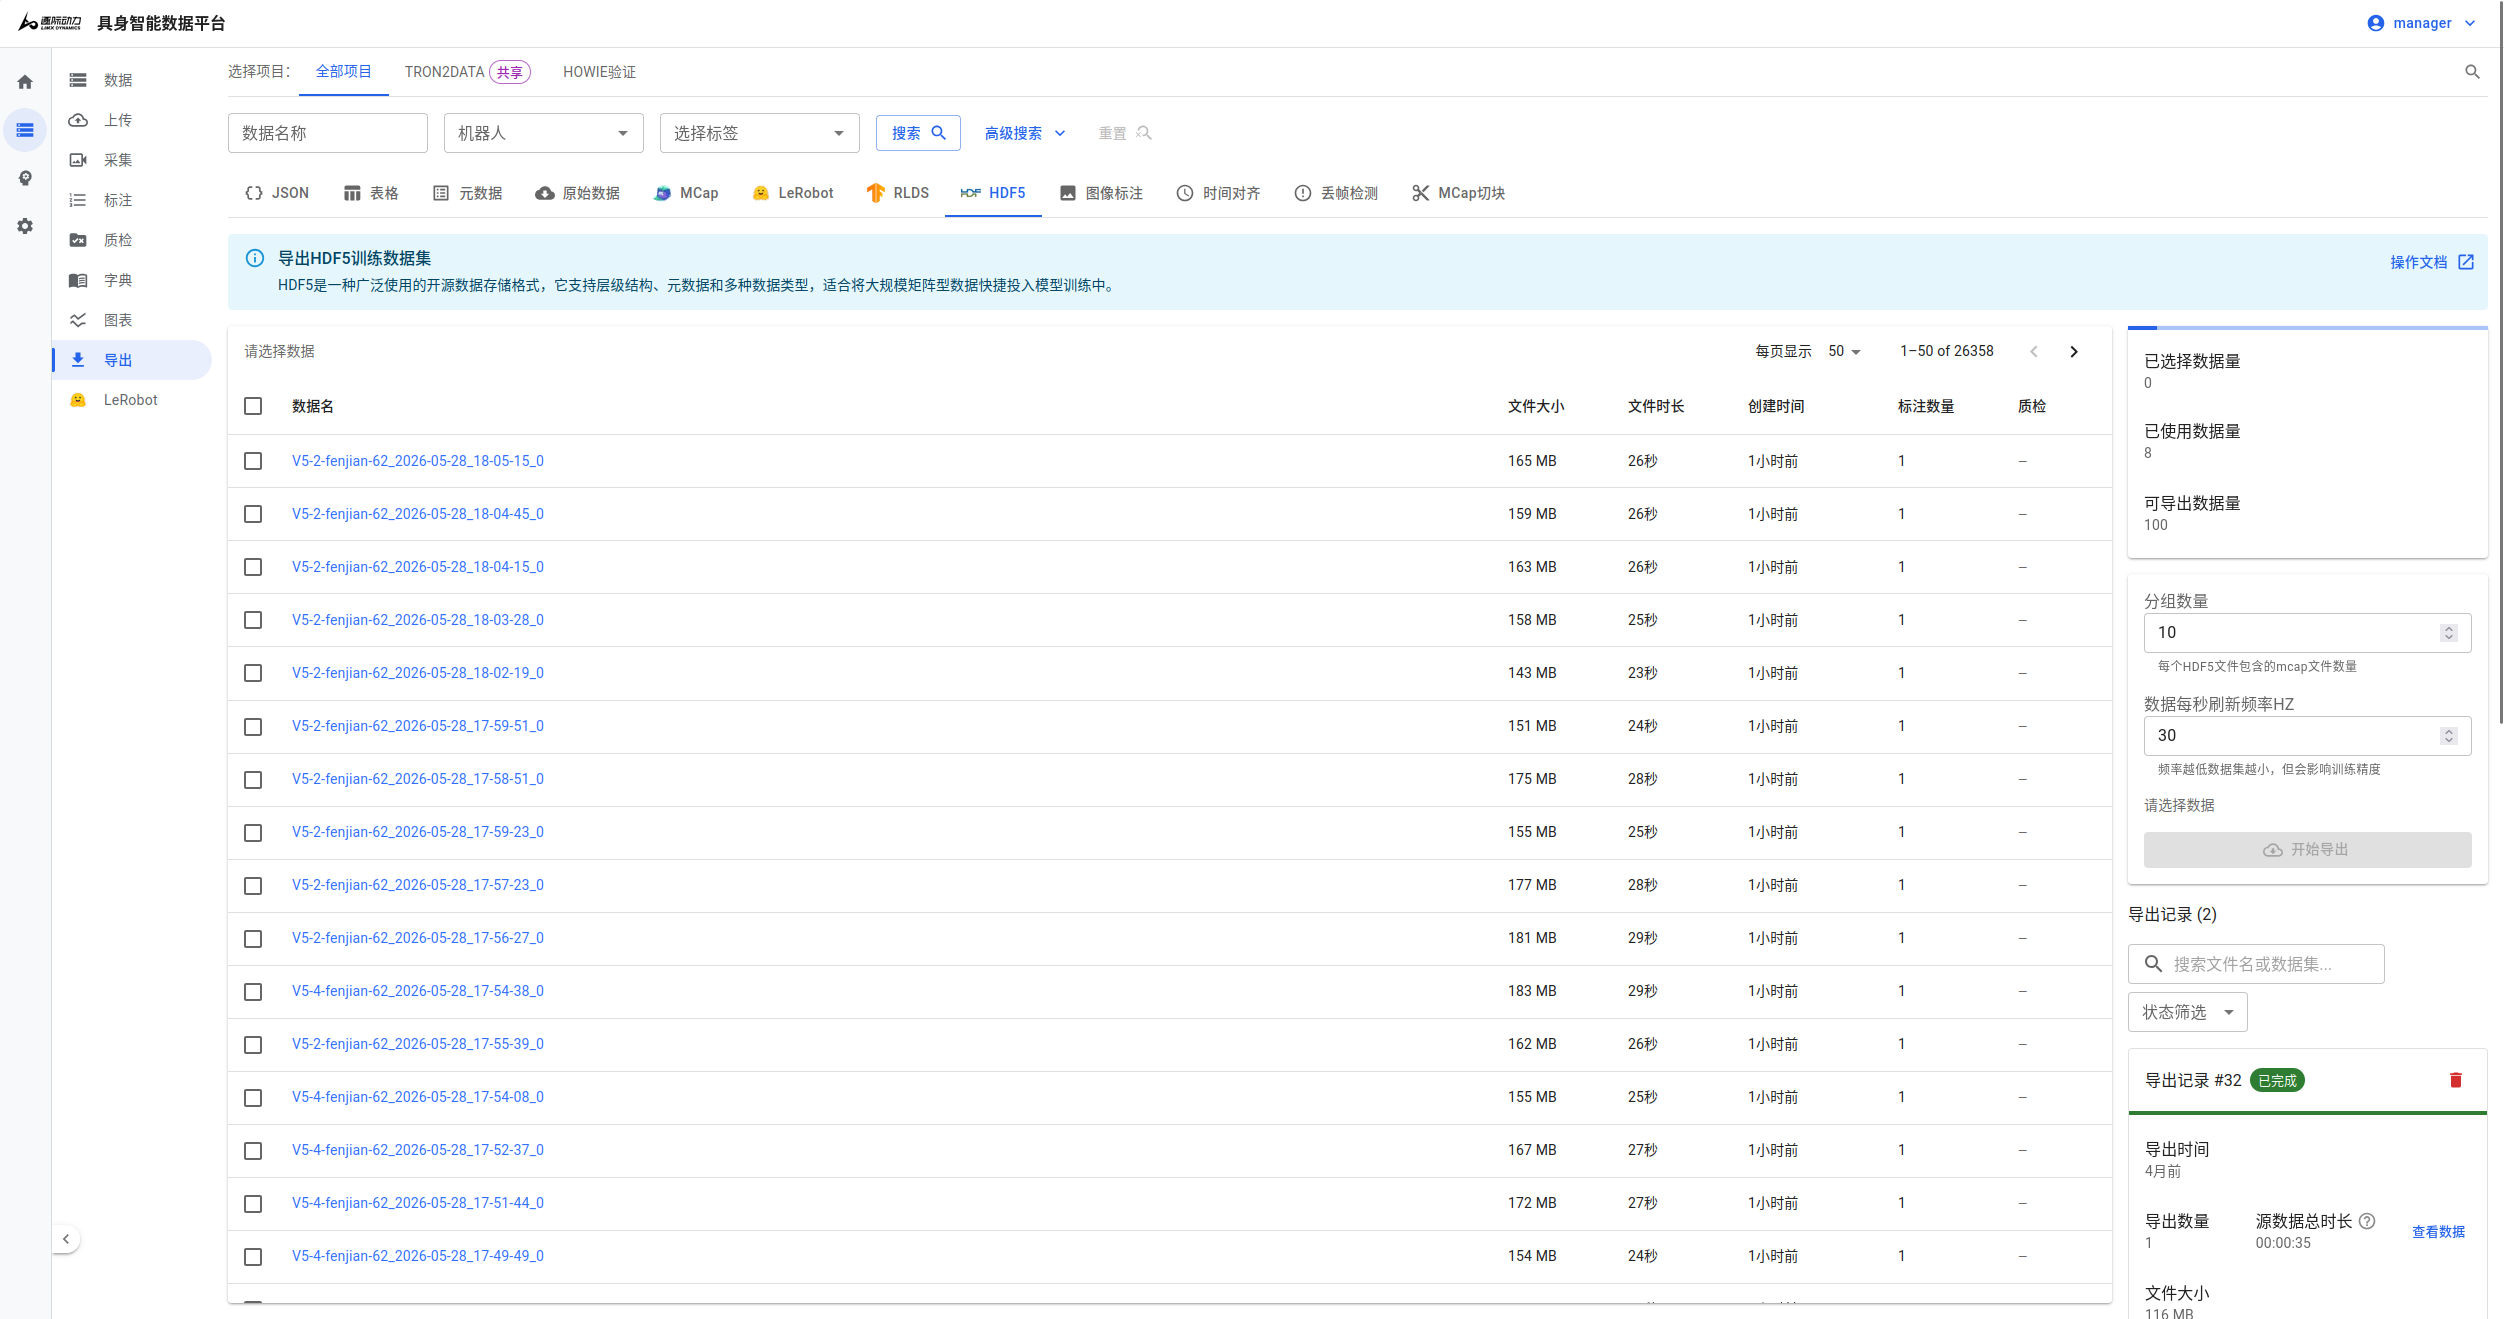
- 分组数量:设置每个HDF5文件包含的原始文件数量。若需一一对应,可设为1。
- 数据刷新频率:控制每秒数据采集次数,影响文件大小。 2.查看导出结果
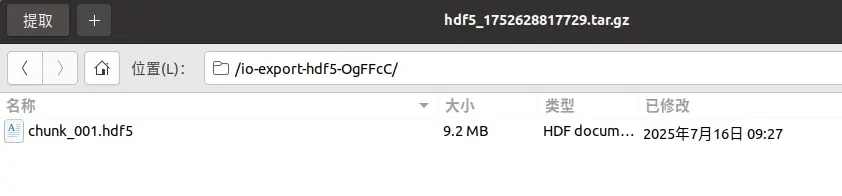
导出后,您可在界面查看结果:
下载后的数据:
3.导出数据结构说明
导出的HDF5文件按原始文件分组命名(如 chunk_001.hdf5),采用树状结构组织数据:
- 根组(/):顶层目录。
- 子组:如
/data、/meta。/data下按标注任务序列划分为子组(如episode_001、episode_002)。
- 数据集:如
/data/episode_001- 属性值包括
task标注的自然语言(英文)task_zh标注的自然语言(中文)score动作质量评分
- 存储的数据包括
action下发的关节指令 (多维数组)observation.images.*各个视角的压缩图像 (JPEG)observation.state传感器的观测值 (多维数组)observation.gripper夹爪闭合状态的观测值 (多维数组)
- 属性值包括
示例结构如下:
HDF5 "./chunk_001.hdf5" {
FILE_CONTENTS {
 group      /
 group      /data
 group      /data/episode_001
 dataset    /data/episode_001/action
 dataset    /data/episode_001/observation.gripper
 dataset    /data/episode_001/observation.images.camera_01
 dataset    /data/episode_001/observation.images.camera_02
 dataset    /data/episode_001/observation.images.camera_03
 dataset    /data/episode_001/observation.images.camera_04
 dataset    /data/episode_001/observation.state
 group      /data/episode_002
 dataset    /data/episode_002/action
 dataset    /data/episode_002/observation.gripper
 dataset    /data/episode_002/observation.images.camera_01
 dataset    /data/episode_002/observation.images.camera_02
 dataset    /data/episode_002/observation.images.camera_03
 dataset    /data/episode_002/observation.images.camera_04
 dataset    /data/episode_002/observation.state
 ......
 group      /meta
 }
}
5.7.4.2 导出为LeRobot数据集
LeRobot 是 Hugging Face 开源的机器人学习数据标准化框架,专为机器人学习和强化学习场景设计。它提供了统一的数据格式规范,使研究人员能够更便捷地共享、比较和复现机器人学习实验,显著降低了不同研究项目之间的数据格式转换成本。
具身数据平台完全支持 LeRobot 标准格式的数据导出,可直接用于 VLA(Vision-Language-Action)模型的训练流程。导出的数据包含机器人操作的完整多模态信息:视觉感知数据、自然语言指令以及对应的动作序列,形成完整的感知-理解-执行闭环数据映射。
LeRobot 格式数据导出需要较高的计算资源支持。具身数据平台对每位用户的导出数量进行了合理限制。
1.选择导出数据
数据导出前需要完成标注工作。标注过程将机器人的动作序列与对应的自然语言指令建立精确映射关系,这是训练 VLA 模型的必要前提。通过这种映射,模型能够学习理解语言命令并将其转化为准确的机器人控制动作。
标注完成后,您可以在导出界面查看所有已标注的数据集。系统支持灵活的数据子集选择,您可以根据具体需求选择特定的数据进行导出。
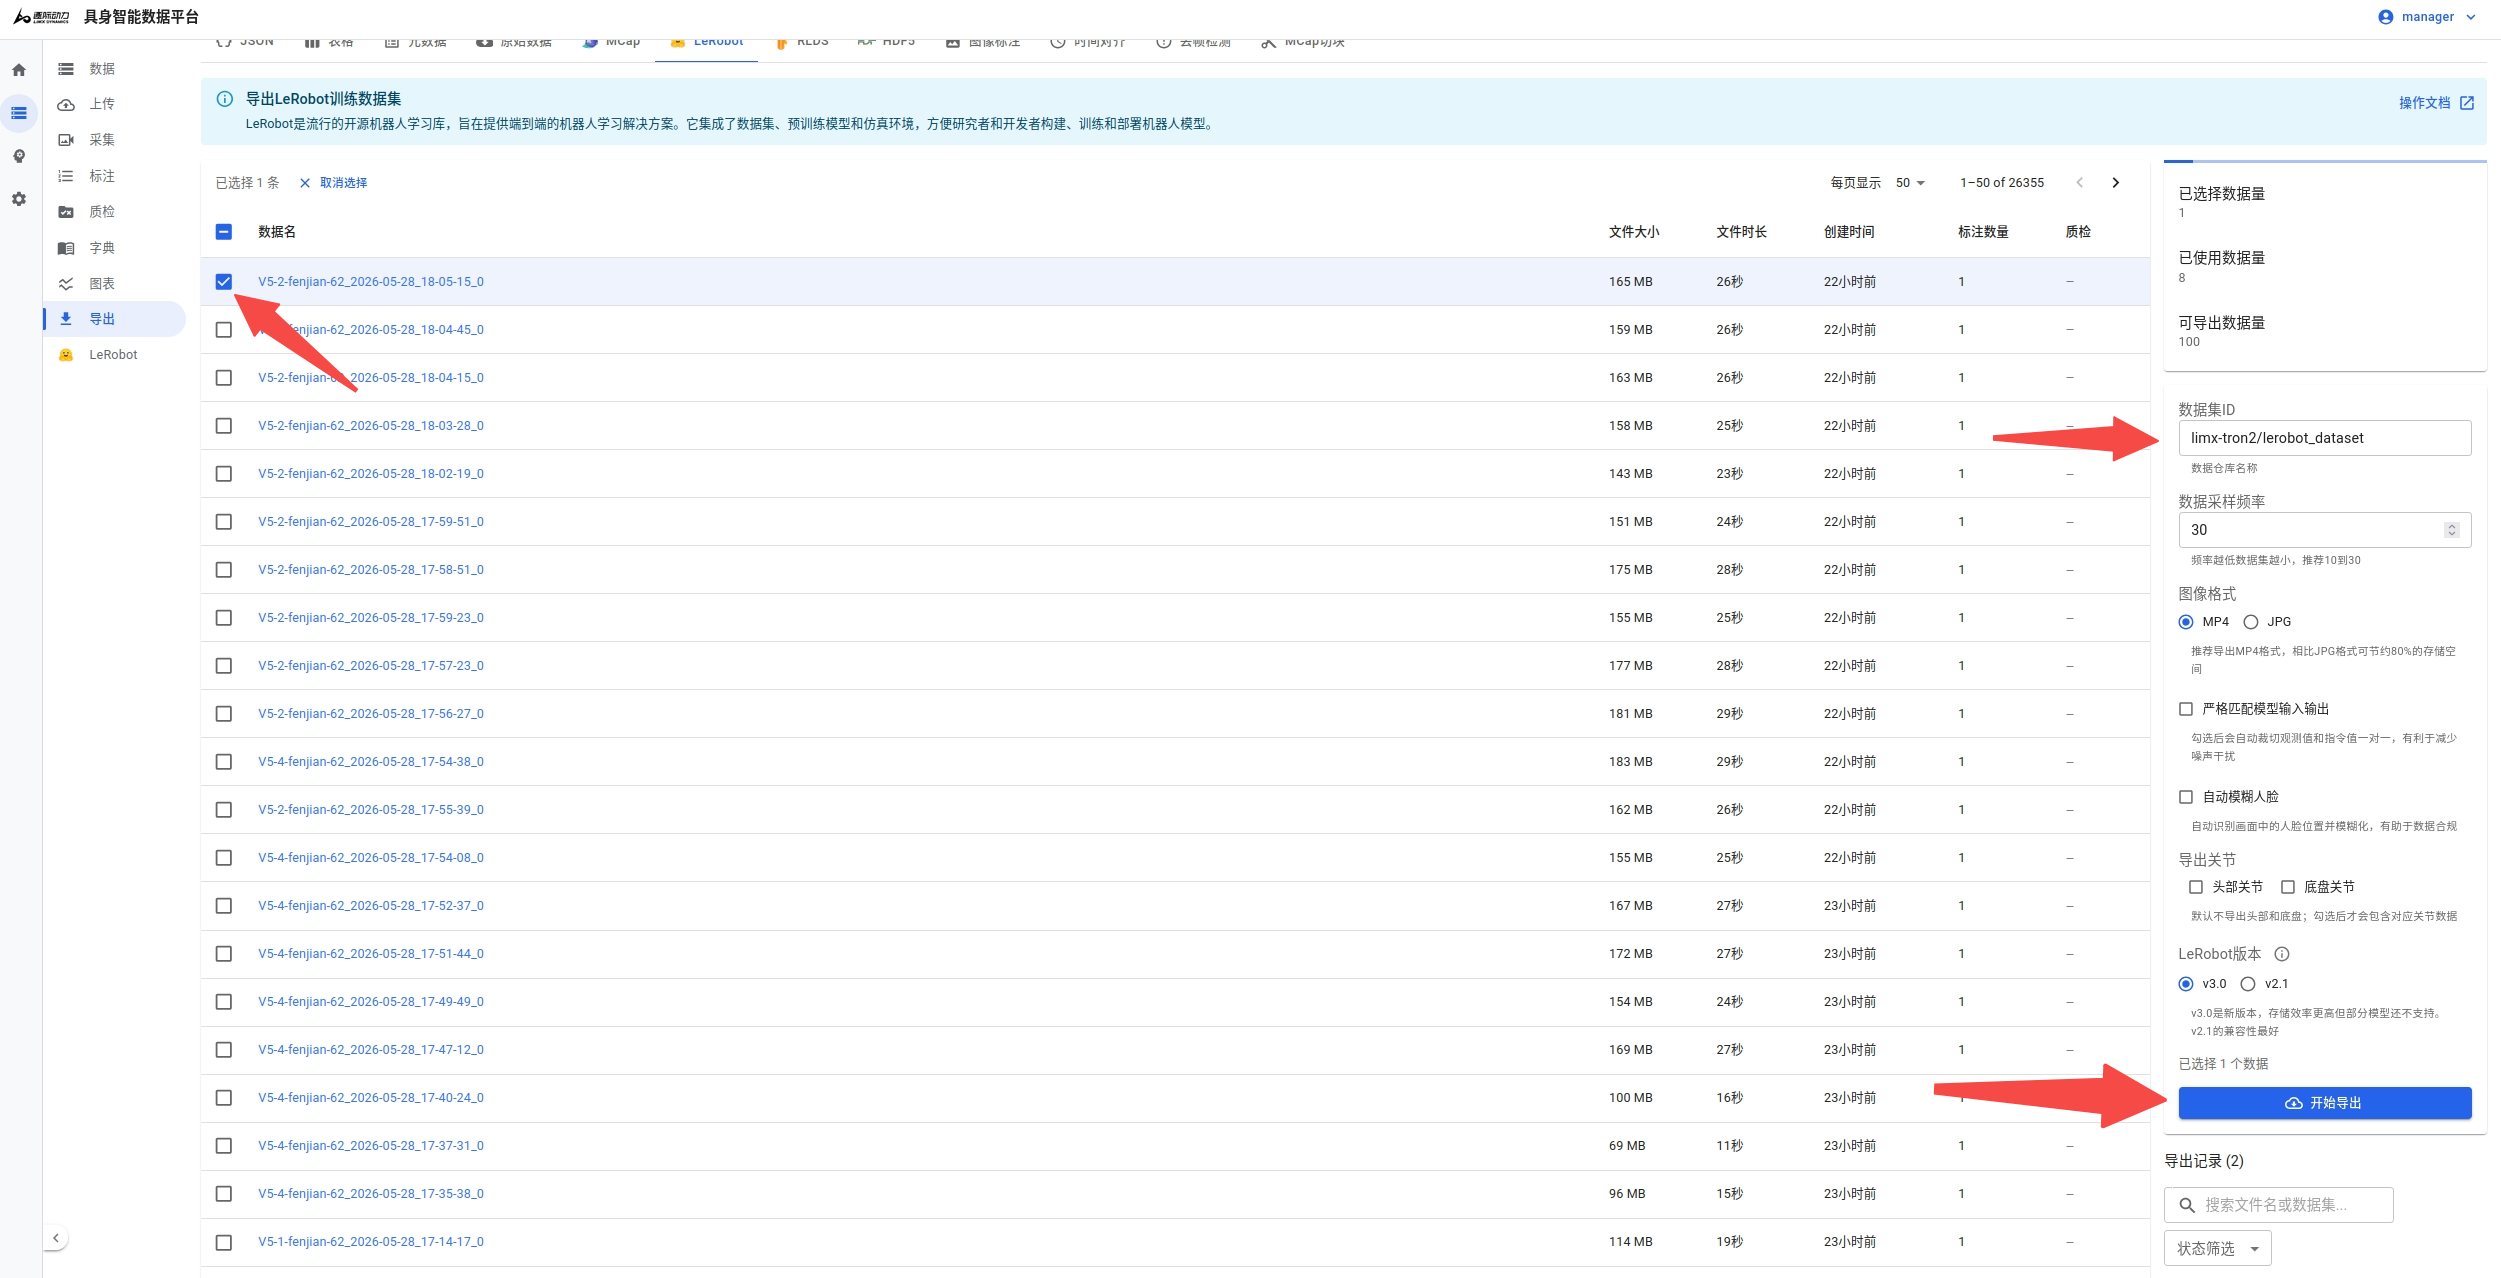
数据集命名支持自定义设置。如果您计划将数据集发布到 Hugging Face 平台,建议采用标准的仓库命名格式(如 myproject/myrepo1),这将为后续的模型分享和协作提供便利。
2.导出配置选项
在导出界面右侧的配置面板中,您可以设置以下导出参数:
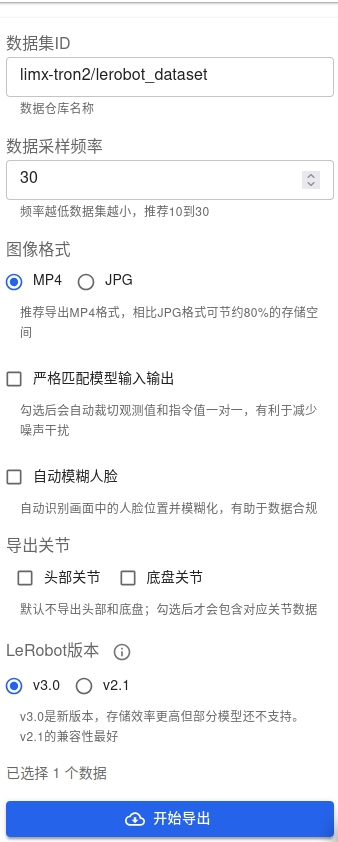
数据采样频率:控制数据采样的频率(推荐 10-30 Hz)。频率越低,生成的数据集体积越小,但可能丢失部分细节信息。
图像格式:
- MP4(推荐):压缩图像格式,可节约约 80% 的存储空间,适合大规模数据集导出
- JPG:原始图像格式,保留完整图像质量,但文件体积较大
严格匹配模型输入输出:启用后系统会自动裁切观测值和指令值,确保一对一对应关系,有助于减少噪声干扰,提升训练数据质量。
自动模糊人脸:启用后系统会自动识别画面中的人脸位置并进行模糊化处理。该功能有助于:
- 保护个人隐私,符合数据合规要求
- 适用于包含操作人员画面的数据集
- 自动处理所有导出图像中的人脸信息
数据量越大,导出耗时越长。建议根据任务类型进行分类导出,避免一次性处理全部数据。分批导出不仅能提升处理速度,还便于后续的数据管理、版本控制和针对性的模型训练
3.下载与解压导出文件
导出过程的耗时取决于数据规模和当前系统负载,通常需要数十分钟。页面会自动更新进度状态,您可以稍后返回查看处理结果。
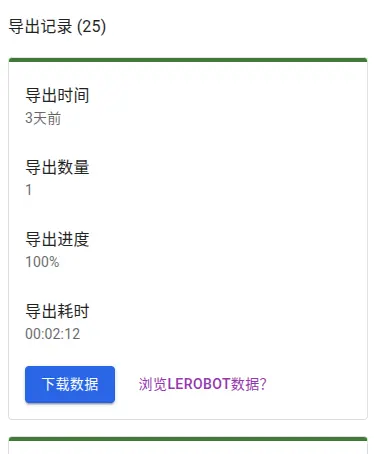
导出完成后,在页面右侧的 导出记录 区域可以看到 下载数据 按钮。点击后将获得一个 .tar.gz 格式的压缩文件包。
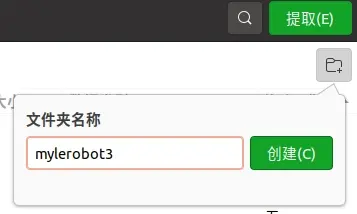
建议在本地创建一个专用目录(如 ~/Downloads/mylerobot3)来解压文件,避免与其他数据混淆:
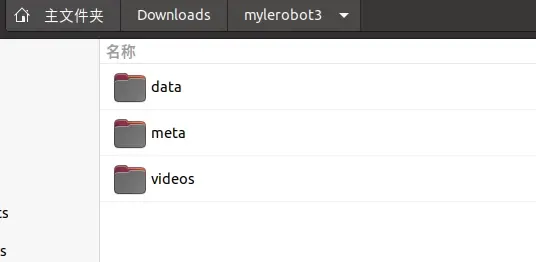
解压后的文件严格遵循 LeRobot 数据集的标准格式规范,包含完整的多模态数据:视觉感知数据、机器人状态信息和动作标签等:
4.自定义Topic映射
在导出 LeRobot 数据集时,系统需要将 ROS/ROS2 话题(Topic)映射到 LeRobot 标准格式中的观测值(Observation.state)和动作(action)字段。了解话题映射规则对于正确导出自定义数据集至关重要。
默认Topic映射规则
具身数据平台采用基于话题名称后缀的自动识别机制:
观测值(Observation.state)映射规则:
- 当话题名称以
/joint_state或/joint_states结尾时,系统会自动将其position字段值识别为观测值,并映射到observation.state字段 - 例如:
io_teleop/joint_states、/arm/joint_state等话题会被识别为观测值
动作(action)映射规则:
- 当话题名称以
/joint_cmd或/joint_command结尾时,系统会自动将其position字段值识别为动作指令,并映射到action字段 - 例如:
io_teleop/joint_cmd、/arm/joint_command等话题会被识别为动作值
为了确保数据能够正确导出,建议在录制数据时遵循上述命名规范。如果您的机器人系统使用了不同的命名风格,可以联系技术支持团队进行适配
自定义Topic支持
如果您构建了自定义话题,而该话题的命名不符合上述默认规则,您可以通过重命名话题方式处理:
重命名话题:在数据录制阶段,将自定义话题重命名为符合默认规则的名称(如 /joint_states 或 /joint_command)
当前版本暂不支持在导出界面直接指定自定义话题映射。如果您有特殊需求,建议提前与技术支持团队沟通,我们会在导出前完成相应的配置适配